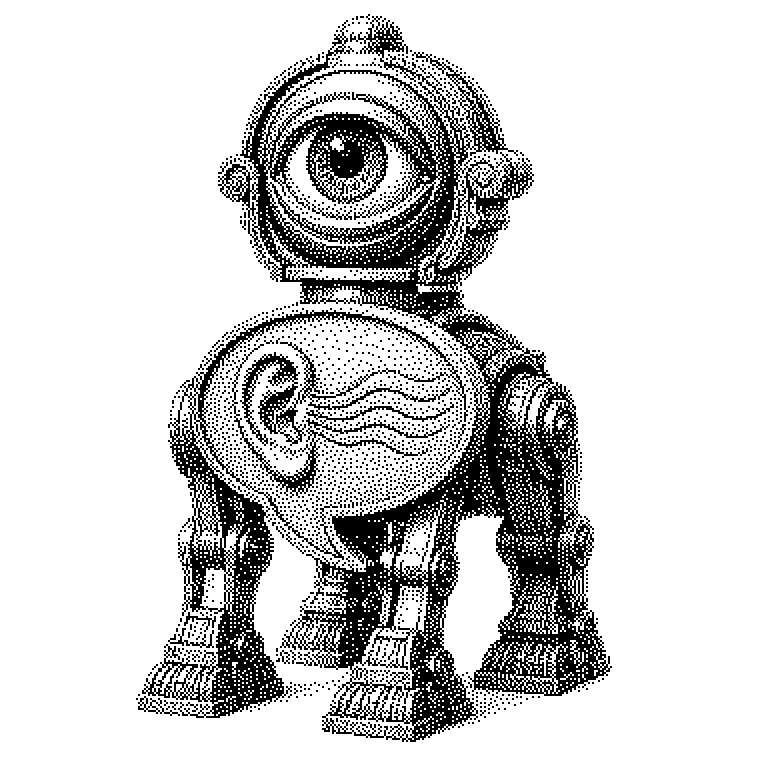
Perception-Language-Action
Ein Perception-Language-Action-Modell ist eine KI-Architektur für Roboter und autonome Systeme, die Sehen, Sprachverstehen und körperliches Handeln in einem einzigen Modell vereint. Statt drei getrennter Systeme übernimmt ein einzelnes Modell den gesamten Weg von der Wahrnehmung bis zur Bewegung.
Ein Perception-Language-Action-Modell – kurz PLA-Modell – verbindet drei Fähigkeiten in einem einzigen System: Wahrnehmen, Verstehen und Handeln. Das Modell sieht seine Umgebung, zum Beispiel über eine Kamera. Es versteht Sprachbefehle, etwa « Räum den Tisch ab ». Und es steuert direkt die Motoren eines Roboterarms. Früher erledigten drei separate Programme diese Aufgaben nacheinander. Ein PLA-Modell tut alles in einem Schritt.
Warum ein gemeinsames Modell einen Unterschied macht
Wenn drei separate Systeme hintereinandergeschaltet sind, pflanzen sich Fehler fort. Das Sehsystem erkennt ein Objekt falsch, das Sprachsystem plant daraufhin die falsche Aktion, der Roboter greift daneben. Jede Schnittstelle zwischen zwei Systemen ist eine neue Fehlerquelle.
Ein PLA-Modell verarbeitet alle drei Ebenen gemeinsam. Bedeutung und Kontext aus dem Sprachbefehl können direkt beeinflussen, wie das Modell das Kamerabild interpretiert – und umgekehrt. Das Ergebnis ist robuster als jede Kette aus Einzelteilen.
Hinzu kommt Flexibilität. Ein PLA-Modell kann auf neue Befehle reagieren, die beim Training nie vorgekommen sind, weil es Sprache und Situation gemeinsam versteht. Ein klassisches Steuerungsprogramm hingegen kennt nur die Befehle, die jemand explizit einprogrammiert hat.
Vom Kamerabild zur Bewegung: der interne Ablauf
Das Modell bekommt gleichzeitig mehrere Eingaben: Bilder der Kamera, Sensordaten über die aktuelle Stellung des Roboters und einen Sprachbefehl als Text. Diese verschiedenen Datentypen werden in eine gemeinsame interne Darstellung übersetzt – Forscher nennen das einen gemeinsamen Repräsentationsraum. Das Modell lernt dabei, Kamerabild und Sprachbedeutung in derselben « Sprache » zu denken.
Aus dieser gemeinsamen Darstellung berechnet das Modell eine Ausgabe: konkrete Steuerbefehle für jeden Motor. Diese Befehle sind keine abstrakten Pläne, sondern direkte Zahlen – wie weit dreht sich Gelenk zwei, wie fest greift der Finger. Diesen letzten Schritt nennt man Action Head, also den Teil des Modells, der auf Handlung spezialisiert ist.
Ein wichtiger Unterschied zu reinen Sprachmodellen: PLA-Modelle müssen in Echtzeit antworten. Ein Chatbot darf eine Sekunde überlegen. Ein Roboterarm, der ein Glas auffangen soll, hat diese Zeit nicht. Das stellt hohe Anforderungen an Rechengeschwindigkeit und Modellgröße.
PLA-Modelle in Produkten und Forschung
Googles Robotikforschung veröffentlichte 2023 mit RT-2 eines der bekanntesten Beispiele: ein Modell, das Kamerabilder und Sprachbefehle gemeinsam verarbeitet und daraus direkt Roboterbewegungen ableitet. Es konnte Aufgaben lösen, die es nie explizit trainiert hatte – etwa ein Objekt nach seiner Farbe sortieren, obwohl es nur gelernt hatte, nach Form zu sortieren.
Auch Unternehmen wie Figure AI oder 1X Technologies arbeiten mit ähnlichen Architekturen für humanoide Roboter – also Roboter mit menschlicher Körperform. Ihr Ziel ist ein Roboter, dem man auf natürliche Sprache hin eine neue Aufgabe beibringen kann, ohne ihn neu zu programmieren.
In der Öffentlichkeit taucht der Begriff vor allem in Berichten über Industrierobotik und autonome Fahrzeuge auf. Selbstfahrende Autos haben ein ähnliches Problem: Sie sehen die Straße, hören Anweisungen des Navigationssystems und müssen lenken und bremsen – alles gleichzeitig und ohne Verzögerung. Die PLA-Architektur ist deshalb kein Nischenthema der Robotikforschung, sondern ein Baustein vieler Technologien, die gerade in den Markt kommen.